Почему стоимость проверенного результата важнее цены модели
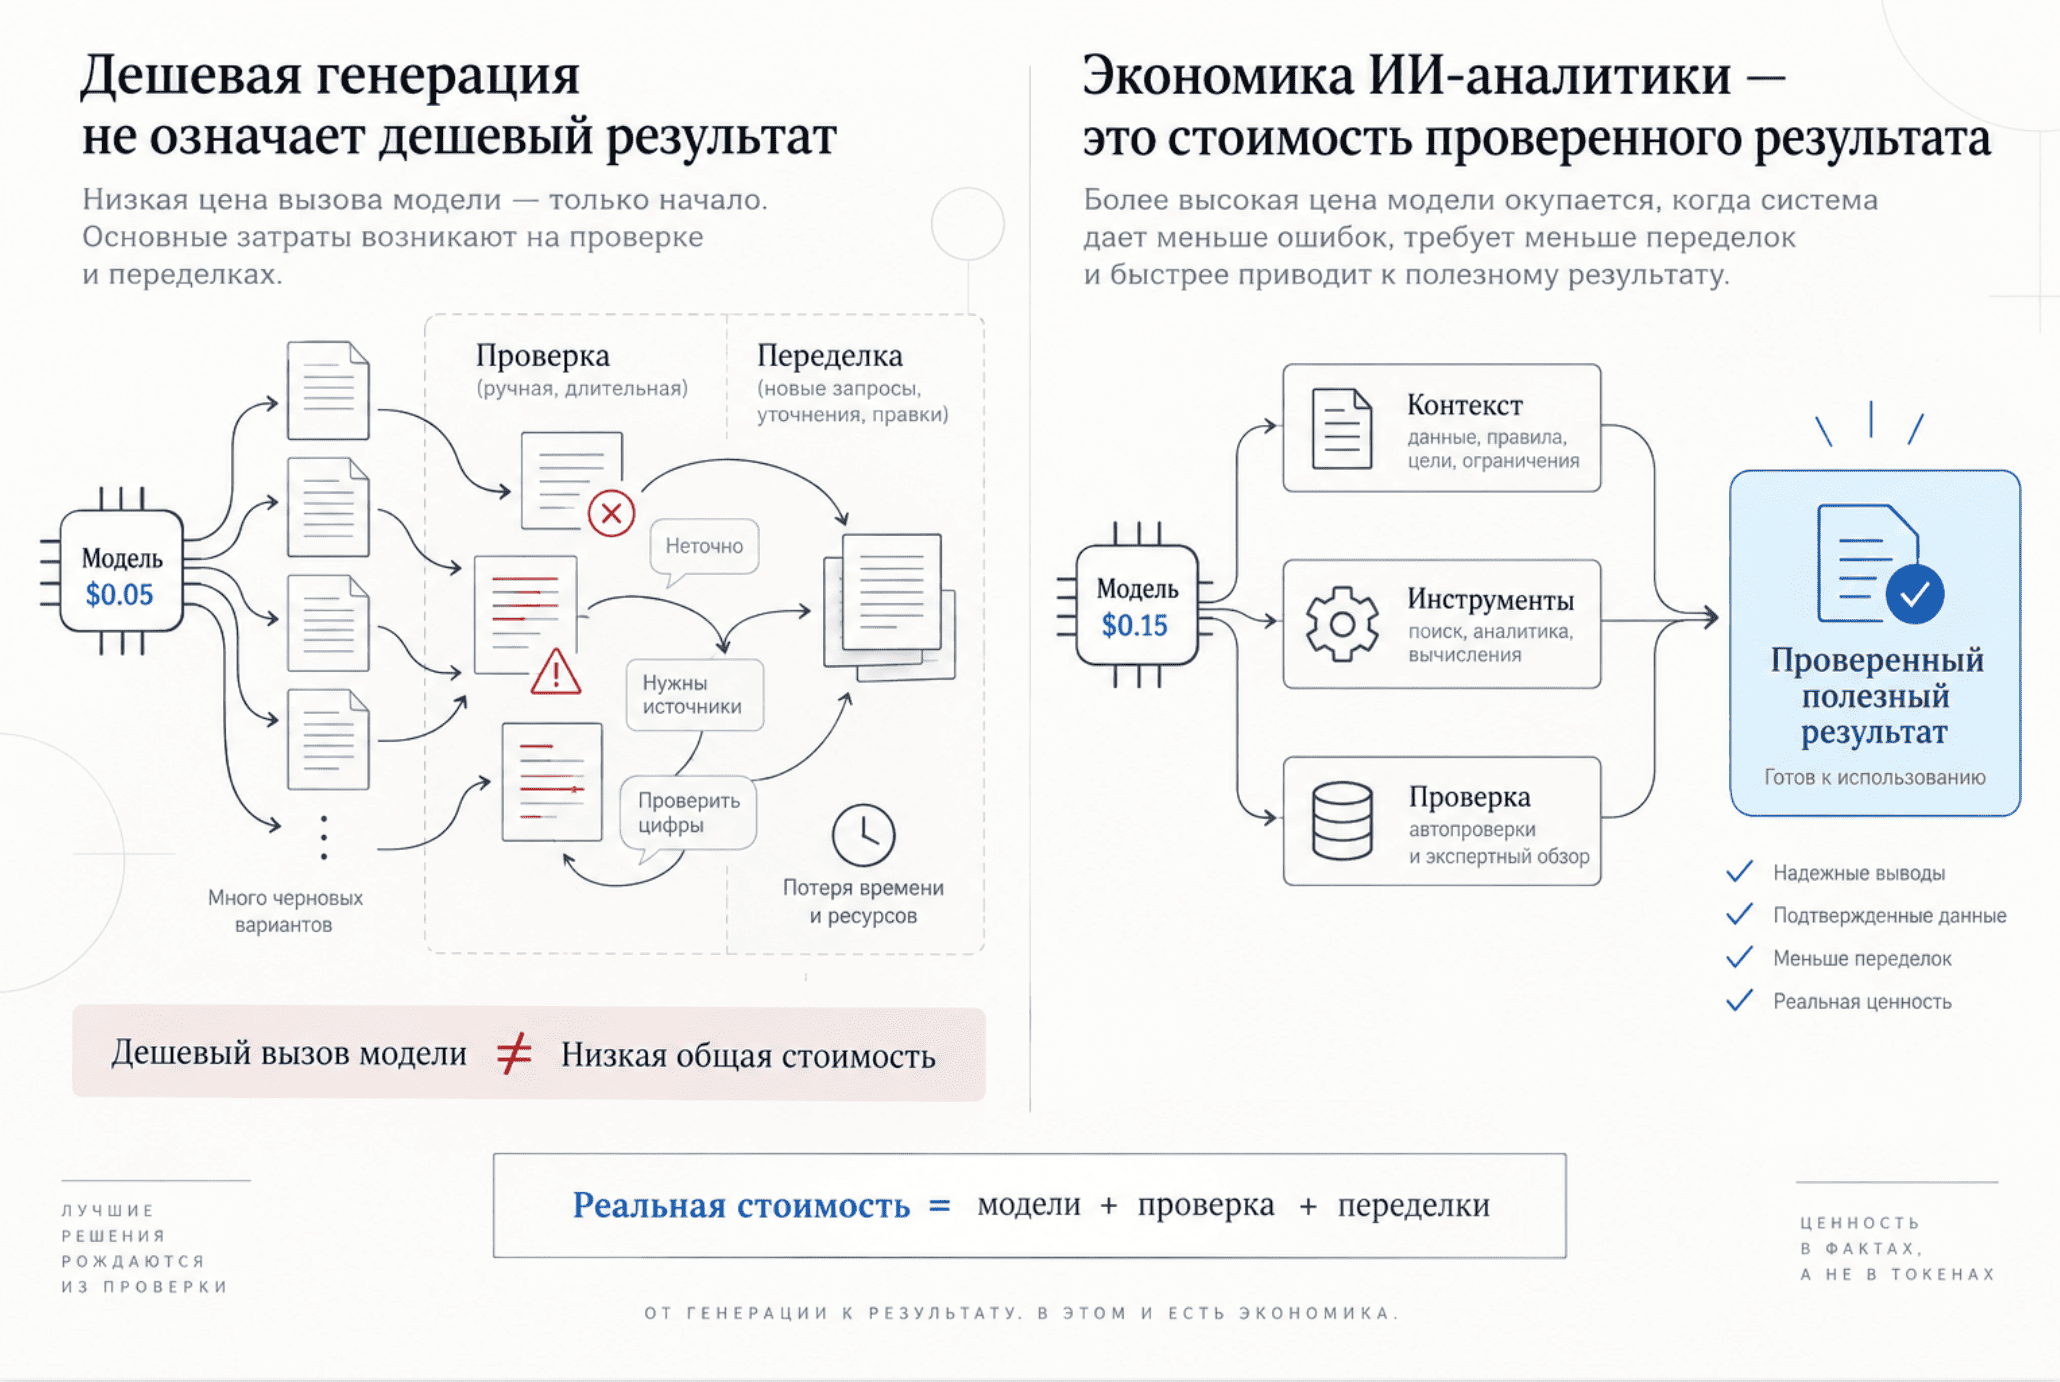
Во время обсуждения создания и внедрения аналитической ИИ-системы в компаниях один из первых вопросов: “Во сколько это нам обойдется?”. При этом часто имеется в виду цена моделей и токенов.
Эти вопросы понятны, и на них достаточно легко ответить. Но это не самые важные вопросы, которыми следует задаваться перед работой над ИИ-аналитикой.
Здесь важнее другое, а именно — то, во сколько бизнесу обойдется результат, с которым можно работать.
Результат аналитической ИИ-системы должен быть таким, чтобы ему можно было доверять и чтобы человеку не приходилось его существенно переделывать. Сегодня это одна из главных проблем многих ИИ-систем: результат выглядит убедительно, но не выдерживает проверки реальностью, и в итоге его приходится постоянно проверять и корректировать. Получается, что компания ускорила один процесс, чтобы застрять на другом.
Я бы считал именно это — стоимость проверенного полезного результата.
Под проверенным полезным результатом я имею в виду результат, который прошел предусмотренный системой контроль и может использоваться человеком без существенной доработки.
Упрощенно его стоимость можно считать так:
Стоимость проверенного полезного результата =
(стоимость моделей + инструментов + инфраструктуры + человеческой проверки + исправлений и повторной обработки) / количество результатов, прошедших установленный контроль качества
Именно такой показатель позволяет сравнивать разные архитектуры ИИ-систем по их реальной экономической эффективности. Причем особенно важны здесь две последние статьи затрат — человеческая проверка и исправления. Они способны свести на нет всю экономию на моделях и инфраструктуре.
Давайте рассмотрим это на примере.
Компания внедрила аналитическую ИИ-систему, один запуск которой обходится в $0,05. В 60% случаев система сразу дает результат, который проходит установленный контроль качества.
Сто запусков стоят $5. Шестьдесят результатов можно использовать практически сразу.
Если смотреть только на стоимость модели, получается около $0,083 на один результат, прошедший контроль с первого раза.
Вроде неплохо.
Но остаются еще сорок случаев. Их нужно перепроверить, где-то повторно запустить часть процесса, а некоторые передать аналитику.
Допустим, каждый такой случай требует в среднем пяти минут работы человека. Это уже 200 минут, или больше трех часов дополнительной работы на каждые сто задач.
Теперь другой вариант.
Один запуск стоит $0,15, то есть втрое дороже. Но система лучше подбирает контекст, использует подходящие инструменты и проверяет результат до того, как он попадет человеку. В итоге 95 результатов из 100 проходят контроль без дополнительной доработки.
Сто запусков стоят $15. Стоимость модели на один такой результат составляет примерно $0,158.
То есть почти вдвое больше, чем в первом случае.
Но теперь аналитику нужно отдельно разбираться только с пятью случаями. При тех же пяти минутах на один случай это около 25 минут работы вместо более чем трех часов.
И вот здесь экономика меняется.
Если обозначить стоимость часа аналитика как H, то для первой системы дополнительные человеческие затраты составят примерно 3,3H на каждые сто задач. Для второй — около 0,4H.
Если для простоты пока не учитывать стоимость повторных запусков, полная стоимость обработки ста задач составит:
- Первая система: $5 + 3,3H
- Вторая система: $15 + 0,4H
Разница в стоимости моделей составляет всего $10 на сто задач. Разница в человеческой работе — почти три часа.
Поэтому уже при стоимости часа аналитика выше примерно $3,5 второй вариант оказывается дешевле в расчете на конечный проверенный результат.
Отсюда следует практический вывод: при проектировании аналитической ИИ-системы недостаточно оптимизировать цену отдельного вызова модели.
Гораздо важнее стоимость результата, который прошел заранее установленный контроль качества и не требует существенной доработки человеком.
Один из главных факторов этой стоимости — доля результатов, которые проходят контроль с первого раза.
Это меняет и сам подход к архитектуре.
Необязательно использовать сильную модель для каждой задачи. Извлечение простых данных можно отдать более дешевой модели или вообще решить обычным программным способом. Сложный анализ — более сильной модели.
Стоит отдельно проверить и то, действительно ли агент нужен для всей цепочки. Чем больше автономных шагов выполняет система, тем больше мест, где ошибка одного шага может перейти в следующий.
Не стоит также передавать модели все документы, которые удалось найти. Ей нужен минимальный контекст, достаточный для решения конкретной задачи.
Если число можно получить запросом к базе данных, лучше получить его оттуда. Если факт доступен через программный интерфейс или надежный источник, лучше обратиться к этому источнику, а не рассчитывать на память модели.
Результат тоже желательно получать в предсказуемой структуре и разделять его составные части. Например: факты, источники, выводы, неопределенности и противоречия в данных. Такой результат значительно проще проверять.
Все эти решения работают на одну задачу: снижать стоимость проверки и исправления результата.
А дальше нужен отдельный слой контроля.
Причем проверяющий модуль — это не обязательно еще одна большая модель. Часть вещей можно проверить обычными правилами: заполнены ли необходимые поля, сходятся ли цифры, указан ли источник, соответствуют ли данные заданному формату.
Модель имеет смысл подключать там, где требуется смысловая проверка. Например, действительно ли вывод следует из приведенных данных или не противоречат ли друг другу разные части анализа.
И только после этого следует подключать человека там, где действительно требуется его профессиональное суждение.
Если аналитик вынужден внимательно проверять каждый ответ ИИ практически с той же тщательностью, с которой выполнял бы работу самостоятельно, экономия становится сомнительной. Мы просто заменили часть работы аналитика другой работой аналитика — проверкой ИИ.
Хорошая система должна сама обрабатывать большинство стандартных случаев и передавать человеку исключения: противоречивые данные, высокую неопределенность, нестандартные ситуации или случаи с высокой ценой ошибки.
Есть еще один важный принцип.
Повторяющаяся ошибка должна приводить к изменению системы.
Если аналитик заметил проблему, исправил ответ и забыл об этом, через неделю система вполне может допустить ту же ошибку снова.
Гораздо полезнее превратить такой случай в новое правило, тест, пример для проверки или условие, при котором задача автоматически отправляется на дополнительный контроль.
Так система постепенно становится надежнее, а стоимость следующего проверенного полезного результата снижается.
В конечном счете именно это и имеет значение. Не сколько стоит отдельный вызов модели, а сколько бизнес платит за результат, который действительно можно использовать.
Комментарии:
Для данной статьи комментарии пока не оставлены.
Будьте первым!